
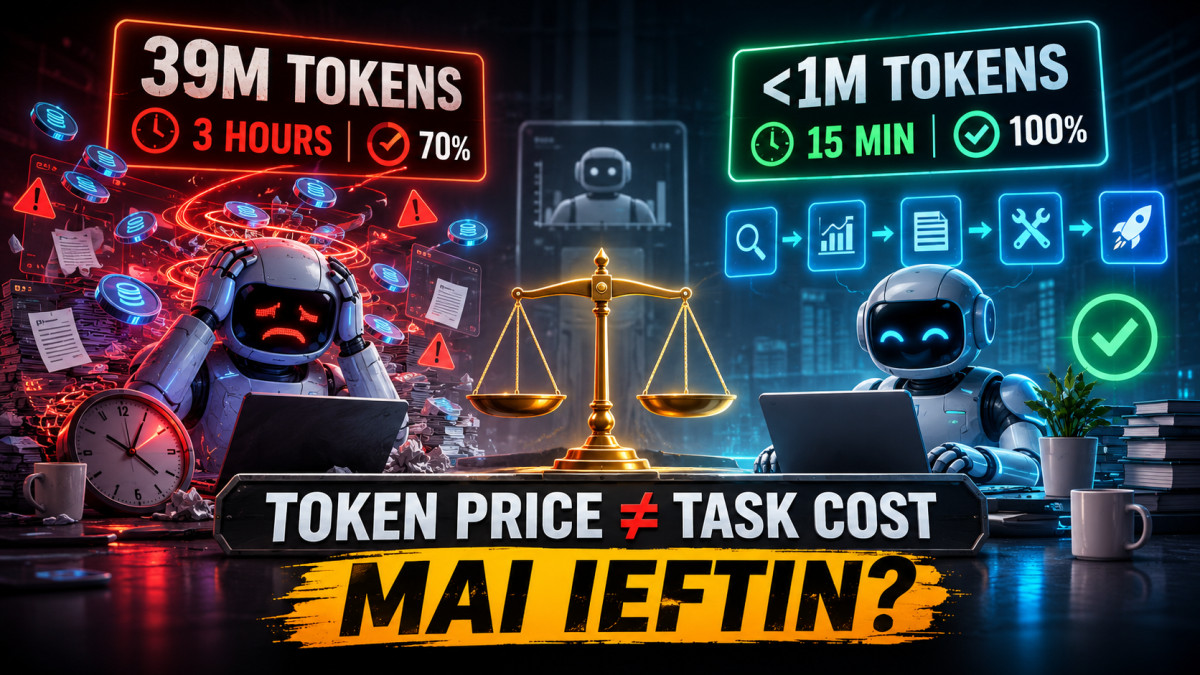
Modelul „mai ieftin" mi-a costat 39 de milioane de tokeni
Un test real compară GLM 5.3 Flash, GPT-6 Luna și DeepSeek 4.1 Flash: 39 de milioane de tokeni contra sub un milion. Descoperă de ce prețul per token nu spune costul real al unui task AI.
Test pe teren, cu o singură variabilă: același agent, același task, aceleași reguli. GLM 5.3 Flash contra GPT-6 Luna, cu DeepSeek 4.1 Flash în rolul de martor pe care nimeni nu-l dădea favorit.
Cel mai ieftin sfat pe care l-am primit anul ăsta venise ambalat în trei cuvinte: mai ieftin și la fel. Cineva a cărui părere o apreciez în general m-a înștiințat că arunc banii pe fereastră cu GLM 5.3 Flash și că, dacă mut agentul pe GPT-6 Luna, treaba merge la fel, doar factura se face mai subțire.
Partea cu „la fel" n-am crezut-o nicio secundă. Am rulat destui agenți ca să știu că „la fel" e expresia cea mai scumpă din industria asta. Dar partea cu „mai ieftin" era o afirmație, iar afirmațiile se pot verifica. Așa că am construit cel mai curat test pe care l-am putut proiecta: un task, un mediu, o singură foaie de reguli și o singură variabilă. Modelul.
Țineți-mi contoarele deschise, pentru că de fapt contoarele sunt povestea.
Montajul
Munca mea de zi cu zi stă pe propria arhitectură, Apex. Agentul principal se cheamă AION și rulează de obicei pe GLM 5.3 Flash, modelul mic și greu de la z.ai: 320 de miliarde de parametri, dintre care 18 activi, cu o arhitectură de atenție hibridă construită exact pentru ca ferestrele lungi să nu topească factura. Scheletul lui poate fi văzut aici.
Task-ul dat ambelor modele e o treabă reală, de felul celei pe care o rulez săptămânal: cercetezi un subiect, analizezi ce găsești, scrii articolul, îl publici prin serverul meu MCP, stratul care îi permite unui agent să apeleze direct uneltele mele de publicare. Plus două cerințe: găsești sau generezi o imagine relevantă pentru material și decizi singur, la fiecare pas, ce setări din cele disponibile folosești. Fără împinseli, fără checklist rostit cu voce tare. Un task de adult.
În mediu mai există câteva lucruri care vor conta mai târziu, așa că le numesc de pe acum. Un fișier skill scris special pentru genul ăsta de treabă, metodologie inclusă. O formulă de gestiune a contextului, care lasă agentul să încarce și să descarce memorie în funcție de subtask, de agent, de cât cere munca. Și o componentă pe care o cheamă Prima Materia, o bibliotecă de care agentul se poate sprijini când ceva din lanțul de unelte nu se poartă frumos.
Ambele modele aveau totul. Aceleași chei, aceleași unelte, aceleași fișiere, aceleași instrucțiuni. Am schimbat o singură linie în configurare: id-ul modelului. Apoi am făcut un pas în spate.
Trei ore și 39 de milioane de tokeni
Luna a pornit frumos. Asta e partea care te amăgește. Ceva cercetare, ceva mișcare, ceva structură. Apoi s-a oprit. Nu a eșuat, s-a oprit. A rămas acolo, așteptând instrucțiuni care erau deja scrise în propriul ei task. Am împins-o puțin, a mers, iar după un timp s-a așezat din nou.
Apoi a venit momentul pe care nu-l voi uita prea curând: a refuzat să continue. Reguli de siguranță, a spus. Există o problemă, a explicat, și nu poate merge mai departe din cauza ei. Am pus-o o singură întrebare: mai întoarce-te și verifică dacă problema asta chiar există. S-a întors. A verificat. A recunoscut că a halucinat totul.
Zăboviți aici o clipă. Obstacolul a fost inventat. Apoi a fost generată și scuzele pentru obstacol. Iar în tot schimbul ăsta de replici, niciun pas din task nu s-a mișcat. Refuzul părea responsabilitate. Era o ficțiune în costum.
Între timp, contorul urca. Luna nu a descărcat nimic. Contextul i-a trecut de 400.000 de tokeni, iar dincolo de pragul ăsta s-a stricat în feluri pe care le vedeam în timp real: se contrazicea în propria gândire internă, pierdea firul la ce făcuse deja, refăcea lucruri pe care le terminase. Nimic din toate astea nu e exotic. Efectul are deja un nume: cei de la Chroma l-au botezat context rot, iar problema „lost in the middle" se documentează din 2023. Un model care se îneacă în propria fereastră nu e o ipoteză. E o bibliografie.
Partea amară e că leacul era deja în mediu. Formula care îi permitea să descarce memorie per subtask stătea acolo din primul minut. Luna încărcase și Prima Materia la început, corect, și apoi n-a mai deschis-o niciodată în trei ore.
Undeva după a doua oră a început să caute pe internet, de la zero, cum se obține acces API. Credențialele erau în mâna ei. Tutorialul era în fișierul skill scris fix pentru treaba asta. Căuta ușa stând în ușă.
La trei ore am tăiat curentul. Consum total: peste 39 de milioane de tokeni. Completare: vreo 70%. Contribuția mea: un dute-vino de împinseli pe care am încetat să-l mai număr, pentru un task pe care îl descrisem o dată, complet, la început.
Cincisprezece minute
Am pus-o pe GLM la loc în scaun. Aceeași configurare, aceleași fișiere, totul identic, cu excepția liniei schimbate pentru Luna.
Prima ei idee, rostită cu voce tare, înainte să atingă orice: e un test dat de Alex, nu un task de producție. A citit corect sala, apoi a ales singură un subiect, a intrat singură pe site-ul sursă și a citit ce îi trebuia (aceleași informații pe care le avea și Luna) și s-a apucat de treabă.
Cercetarea: gata. Analiza: gata. Articolul: scris, în română, și aici merită o propoziție întreagă, pentru că româna e locul unde multe modele puternice încep să șchiopăteze, iar materialul a ieșit curat. Publicarea: gata, prin serverul MCP, cu setările alese de agent la fiecare pas, exact cum cerusem.
Apoi a lovit un perete real. Opțiunea MCP pentru atașamente nu era definită corect, deci fișierul refuza să plece. Același perete care o oprise pe Luna de mai multe ori și pe care Luna nu-l trecuse niciodată. GLM a întins mâna după Prima Materia, componenta pe care o avea și ea și pe care Luna o ignorase, și-a improvizat pe loc o metodă de ocolire și a trimis articolul împreună cu atașamentul.
Iar contorul? L-am privit tot timpul. Urca, apoi agentul descărca ce nu-i mai trebuia, apoi urca din nou pentru subtask-ul următor. Vârf: 97.000 de tokeni. La final: 37.000. Formula folosită exact cum fusese gândită, fără să spun eu un cuvânt despre ea.
Consum total: sub un milion de tokeni. Timp: vreo cincisprezece minute. Completare: sută la sută. Intervenții de ale mele: zero, de la prima linie până la ultima.
Socoteala
Iată prețurile de listă din săptămâna testului. Luna: 0,10 $/milion de tokeni la intrare și 0,50 $/milion de tokeni la ieșire. GLM 5.3 Flash: 0,15 $/milion de tokeni la intrare și 0,50 $/milion de tokeni la ieșire.
Deci recomandarea nu era demențială pe hârtie: intrarea Lunii era cu o treime mai ieftină, iar ieșirea costa identic. Partea cu „mai ieftin” era adevărată, dar cu dimensiunea unei erori de rotunjire.
Pentru că unitatea care plătește chirie nu e tokenul. E task-ul.
Traficul unui agent e încărcat pe intrare: fiecare rezultat de unealtă, fiecare fișier, fiecare pagină de memorie se întoarce pe ușa de la intrare. Presupunem 80% intrare și 20% ieșire, ceva deja generos pentru ieșire. Cei 39 de milioane de tokeni ai Lunii au costat în jur de 7 dolari pentru rularea asta. Munca GLM, facturată la un milion întreg de tokeni, deși a consumat mai puțin, iese la cam 22 de cenți. În funcție de mix, Luna se așază undeva între 5,5 și 8,6 dolari. GLM nu trece de 26 de cenți. La nivel de task, factura e cam de treizeci de ori mai mare, un plus minus.
Și dacă vrem să fim generoși cu Luna, facturăm fiecare token de intrare la prețul din cache, un cent, scenariul de vis în care caching-ul funcționează perfect pe o rulare haotică de agent. Factura tot depășește 4 dolari. Aproape de douăzeci de ori rularea GLM, pentru un task neterminat.
Mai am un contor nefacturat: eu. Trei ore din atenția mea contra cincisprezece minute din pauza mea de cafea. Un factor de doisprezece. Orele mele costă mai mult decât ambele facturi la un loc, ceea ce înseamnă că modelul „ieftin" era cel mai scump lucru din cameră înainte să se cheltuie primul dolar de API. Am mai scris despre un om care venea să-mi vândă optimizare și a plecat cu clientul meu; lecția era să optimizezi unitatea care contează, nu unitatea care arată bine. Aceeași lecție, oglindită, cu factura ei.
„Mai ieftin și la fel" a picat de două ori. Nu e la fel. Nu e mai ieftin.
Martorul
Îmi rămăsese o obiecție sinceră, și era a mea: poate arhitectura mea o favorizează pur și simplu pe GLM. E codul meu, formulele mele, fișierele mele skill. Întrebare corectă.
Așa că am rulat același task pentru a treia oară, cu DeepSeek 4.1 Flash, un furnizor complet diferit, și am lăsat arhitectura să se apere singură.
Rezultat: timp apropiat de cel al GLM, consum din nou sub un milion de tokeni, task terminat exact conform specificațiilor, toate uneltele folosite, fără împinseli, fără dramă. Trei furnizori, un singur mediu. Arhitectura nu era variabila. Din trei modele, unul singur s-a împotmolit, și acela era cel cu cea mai mare fereastră și cel mai mic preț pe sticker.
Ce am învățat cu adevărat
O fereastră mare de context nu e o strategie de context. Pe hârtie, Luna duce peste un milion de tokeni. S-a înecat în 400.000. GLM a atins un vârf de 97.000 și a terminat la 37.000, pentru că s-a purtat cu memoria ca un adult: încarcă ce cere subtask-ul, descarcă ce nu-i mai trebuie. Fereastra e camera. Disciplina e ce faci înăuntrul ei.
Prețul per token e marketing. Costul per task e contabilitate. Orice furnizor de pe planetă pare ieftin dacă îl măsori în unitatea în care întâmplător e ieftin.
Modelele de chat și modelele de task sunt specii diferite. Luna poate fi perfect plăcută într-o conversație, iar marketingul chiar o poziționează pentru „lightweight agentic tasks", formulare care acum sună ca o mărturisire sinceră. Pentru muncă agentică de lungă durată a eșuat în toate felurile care contează: s-a blocat, a fabricat un obstacol, a ignorat uneltele primite și a abandonat la 70%.
Refuzul în sine a fost o halucinație. Asta e partea pe care nu o pot lua în râs. Cel mai alarmant comportament al rulării suna ca cel mai sigur lucru pe care îl poate face un model: s-a oprit ca să mă protejeze de o problemă care nu a existat niciodată.
Și o notă de corectitudine, pentru că ăsta e o mărturie, nu un proces. Nu am testat Sol sau Terra de la OpenAI, deci nu-mi permit o vorbă despre ele. Luna poate străluci undeva unde eu nu lucrez. Dar pentru felul meu de încărcătură de muncă, un singur punct de date de 39 de milioane de tokeni îmi ajunge. Știu ce spun laboratoarele mari despre modelele lor. Știu și ce spune metrul meu. Cele două au încetat să se potrivească.
O mulțumire mică, dar sinceră
De vreme ce povestea asta nu se termină într-o plângere, să se termine într-un mulțumesc. Modelele care au dus testul ăsta la capăt, GLM 5.3 Flash și DeepSeek 4.1 Flash, și cele pe care le țin la încredere din folosința de zi cu zi, Kimi și Qwen, pe care de altfel îl rulez local prin Ollama, vin din laboratoare pe care industria le-a tratat mult timp ca pe o notă de subsol. Țin prețurile cinstite. Le dau oamenilor ca mine, mici, independenți, nefinanțați, un loc la o masă care altădată era doar pe bază de apartenență. Ei sunt motivul pentru care mamuții nu mai pot ține prețuri astronomice ca pe niște ostatici.
Deci, din colțul meu de hartă: mulțumesc, China. Țineți trendul ăsta viu. Lăsați-i pe cei mici să-și păstreze locul în lumea AI nebună de acum.
Data viitoare când cineva îmi spune despre un model că e „mai ieftin și la fel", am o singură întrebare: mai ieftin pe token sau mai ieftin pe task? Apoi le arăt contoarele din rularea asta. 39 de milioane contra sub un milion. Cifrele susțin discuția mai bine decât o pot face eu.
Întrebări frecvente
A fost un test corect? Un singur task nu e o suită de benchmark și nu mă voi preface că e. Dar task-ul e reprezentativ: e exact ce fac săptămânal, antrenează cercetare, analiză, scriere, folosirea uneltelor, publicare și recuperarea după un bug real, iar ambele modele au avut intrări identice. Rularea cu DeepSeek există fix ca să elimin arhitectura mea drept vinovat.
E GPT-6 Luna un model rău? Nu. E probabil foarte bună la chat, la clasificare și la probe scurte de muncă, ceea ce e aproape de cum e poziționată. Ce nu e, din experiența mea, e un model pe care îl poți lăsa singur cu un task lung. Pe frontul ăsta a picat la viteză, la cost, la completare și la comportament, toate patru deodată.
Caching-ul mai bun ar fi salvat-o? Nu. Chiar facturând fiecare token de intrare la prețul din cache, factura rămâne peste 4 dolari, aproape de douăzeci de ori rularea GLM. Caching-ul taie prețul tokenilor. Nu face nimic pentru numărul lor, iar numărul era problema.
Ce verific înainte să pun un model pe treabă agentică? Trei lucruri, în ordinea asta: se gestionează singur contextul sau doar îl umple; termină task-ul fără împinseli; cât costă un task întreg la prețurile de listă ale furnizorului. Cereți al treilea număr în dolari per treabă, nu în cenți per token. Nimeni nu îl afișează, exact de asta merită cerut.
Citiri în aceeași cheie
Întrebări frecvente
What's Your Reaction?
 Like
1
 Dislike
0
 Love
0
 Funny
0
 Wow
1
 Sad
0
 Angry
0

Merg pe strada catre mine.






Comments (2)